在AI推理场景中,算力数字往往最受关注,但真正决定一颗芯片能否把算力释放出来的,常常是显存带宽。乐球吧行业资讯栏目在整理公开资料时发现,随着大模型推理向更长上下文、更大批量方向演进,显存带宽与容量已经成为设计端、封装端和应用端共同关注的焦点。本文从芯片设计、架构演进、封装方式与应用场景四个环节,为读者梳理这一变化背后的产业逻辑。
一、推理负载的特殊性决定了带宽优先级
结论前置地说,推理阶段的瓶颈往往不在峰值算力,而在数据搬运效率。训练阶段可以容忍较长的迭代周期,推理阶段则对时延和吞吐同时提出要求,权重读取、KV缓存读写都会持续占用显存带宽。
从公开的芯片设计资料看,推理芯片通常需要在有限功耗预算内平衡计算单元数量与显存接口宽度。乐球吧在梳理架构演进信息时注意到,不少面向推理的产品选择以更宽的显存接口配合更大的片上缓存,减少重复访存。对于长上下文场景,KV缓存体积随序列长度增长,带宽压力进一步放大,这也是架构设计中越来越多引入分级缓存与近存计算思路的原因。
- 权重读取:每次前向计算都要读取大量参数,带宽不足会直接拉低吞吐。
- KV缓存:长上下文与大批量并发会显著增加缓存读写频次。
- 片上缓存:合理的缓存层级能减少对片外显存的重复访问。
二、HBM与先进封装如何协同缓解带宽压力
高带宽显存之所以成为推理芯片的常见选择,核心在于它通过堆叠方式在有限面积内提供更多数据通道。乐球吧在整理封装方式相关公开信息时看到,高带宽显存的代际演进不仅提升单堆栈带宽,也在能效比上持续优化,这对功耗敏感的推理部署尤为重要。
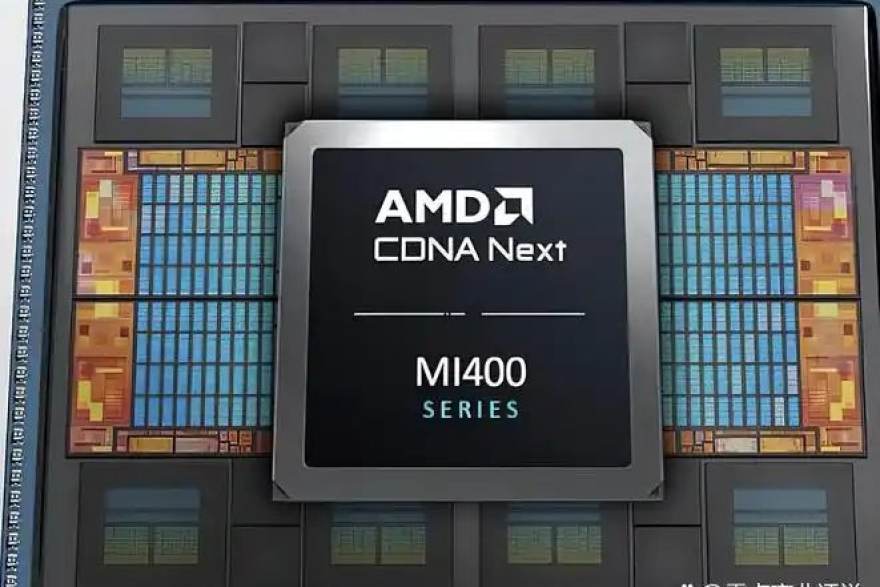
更值得关注的是封装环节的变化。硅中介层与2.5D封装让计算芯粒与显存堆栈之间的距离缩短,从而在提升带宽的同时控制信号完整性风险。部分面向推理的设计开始采用芯粒拆分思路,把计算、缓存与接口分别规划,再通过先进封装集成。乐球吧提醒读者,这类方案对封装良率与散热设计提出更高要求,产业链各环节的协同程度直接影响产品落地节奏。
从制程节点角度看,计算逻辑部分持续向更先进节点演进,而显存与接口电路未必同步跟进,这种差异也让先进封装成为连接不同工艺节点的关键桥梁。乐球吧在梳理产业动态时发现,封装能力正在从后道工序转变为影响芯片定义的前置变量。
三、应用场景差异带来的选型思路
不同推理场景对带宽的敏感度并不相同。云端批量推理更看重吞吐与显存容量,边缘侧推理则要在带宽、功耗与成本之间取平衡。乐球吧建议读者在理解产品参数时,把显存带宽与容量、能效比、接口形态放在同一张表里对照,而不是只看单一算力指标。
- 云端服务:高并发与长上下文场景优先关注带宽与容量配比。
- 边缘设备:带宽需求相对可控,更看重功耗与封装体积。
- 行业应用:需结合部署环境评估散热与长期稳定性。
总体来看,AI推理芯片的竞争正在从单纯比拼算力,转向算力、带宽与封装能力的系统级平衡。乐球吧行业资讯栏目将持续按芯片设计、架构演进、制程节点、封装方式与应用场景归类整理公开信息,保留来源类型与更新时间,帮助读者快速把握产业链各环节的近期变化。
网友评论
来自乐球吧读者的观点交流